AlexNet ஆழ்ந்த பார்வை: அடுக்கு கணிதம், பிந்தைய கட்டமைப்புகள் மற்றும் PyTorch குறியீடு
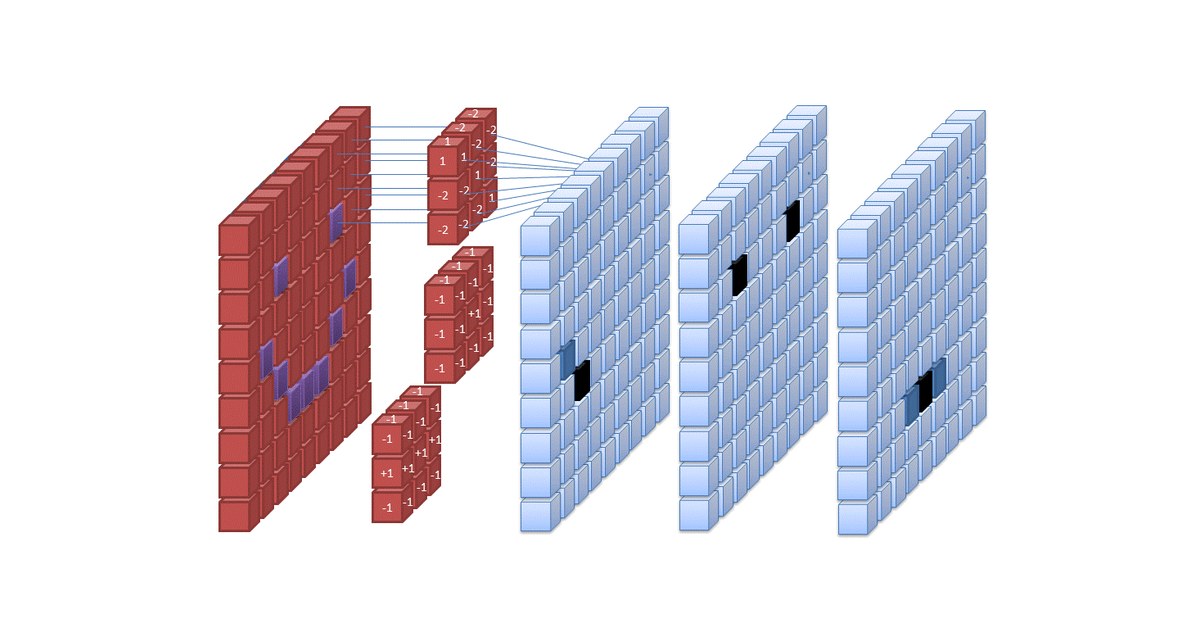
விளக்கப்படம்: Three filters (kernels) in the first layer of a convolutional network scanning an image. படம்: Cecbur, CC BY-SA 4.0, via Wikimedia Commons.
1. அடுக்கு வாரியான கணிதப் பிரிப்பு
எந்தவொரு convolutional அல்லது pooling அடுக்கின் இடஞ்சார்ந்த வெளியீட்டு அளவுகளைக் கணக்கிட, AlexNet பின்வரும் நிலையான சூத்திரத்தைப் பயன்படுத்துகிறது:
வெளியீட்டு அளவு = ⌊ (உள்ளீட்டு அளவு − Kernel அளவு + 2 × Padding) / Stride ⌋ + 1
(குறிப்பு: 2012 மூலக் கட்டுரையில் ஒரு சிறிய எழுத்துப் பிழையால் உள்ளீட்டு அளவு 224 × 224 × 3 என எழுதப்பட்டிருந்தது; அடுக்கு 1-இல் 55 × 55 வெளியீடு கிடைக்க, துல்லியமான கணக்கீட்டிற்கு 227 × 227 × 3 உள்ளீடு தேவை).
| அடுக்கு | வகை | உள்ளீட்டு வடிவம் | Filter / Kernel | Stride | Padding | வெளியீட்டு வடிவம் | கற்ற அளவுருக்கள் |
|---|---|---|---|---|---|---|---|
| Input | படம் | 227 × 227 × 3 | — | — | — | 227 × 227 × 3 | 0 |
| Conv1 | Convolution + ReLU | 227 × 227 × 3 | 96 × (11 × 11 × 3) | 4 | 0 | 55 × 55 × 96 | 34,944 |
| Pool1 | Max Pooling | 55 × 55 × 96 | 3 × 3 | 2 | 0 | 27 × 27 × 96 | 0 |
| Conv2 | Convolution + ReLU | 27 × 27 × 96 | 256 × (5 × 5 × 96) | 1 | 2 | 27 × 27 × 256 | 614,656 |
| Pool2 | Max Pooling | 27 × 27 × 256 | 3 × 3 | 2 | 0 | 13 × 13 × 256 | 0 |
| Conv3 | Convolution + ReLU | 13 × 13 × 256 | 384 × (3 × 3 × 256) | 1 | 1 | 13 × 13 × 384 | 885,120 |
| Conv4 | Convolution + ReLU | 13 × 13 × 384 | 384 × (3 × 3 × 384) | 1 | 1 | 13 × 13 × 384 | 1,327,488 |
| Conv5 | Convolution + ReLU | 13 × 13 × 384 | 256 × (3 × 3 × 384) | 1 | 1 | 13 × 13 × 256 | 884,992 |
| Pool3 | Max Pooling | 13 × 13 × 256 | 3 × 3 | 2 | 0 | 6 × 6 × 256 | 0 |
| Flatten | வடிவ மாற்றம் | 6 × 6 × 256 | — | — | — | 9,216 | 0 |
| FC6 | Fully Connected + ReLU | 9,216 | 9,216 × 4,096 | — | — | 4,096 | 37,752,832 |
| FC7 | Fully Connected + ReLU | 4,096 | 4,096 × 4,096 | — | — | 4,096 | 16,781,312 |
| FC8 | Fully Connected + Softmax | 4,096 | 4,096 × 1,000 | — | — | 1,000 | 4,097,000 |
- மொத்த அளவுருக்கள்: 62,378,344 (~62.4 மில்லியன்). இந்த அளவுருக்களில் 93%-க்கும் மேல் கடைசி மூன்று fully connected அடுக்குகளில் (FC6, FC7, FC8) உள்ளன.
- Local Response Normalization (LRN): முதலில் Conv1, Conv2-க்குப் பிறகு பயன்படுத்தப்பட்ட LRN, அண்டை channel-கள் முழுவதும் நியூரான் செயல்பாட்டை இயல்பாக்கியது. நவீன செயலாக்கங்கள் LRN-ஐ Batch Normalization-ஆல் மாற்றுகின்றன அல்லது முழுவதுமாக விலக்குகின்றன.
2. பரிணாமம்: AlexNet மற்றும் பிந்தைய கட்டமைப்புகள்
2012-க்குப் பிறகு வந்த ஒவ்வொரு முக்கிய கட்டமைப்பும், AlexNet வெளிப்படுத்திய ஒரு குறிப்பிட்ட தடையைத் தீர்த்தது.
| அம்சம் | AlexNet (2012) | VGG-16 (2014) | ResNet-50 (2015) | Vision Transformer / ViT (2020) |
|---|---|---|---|---|
| மையப் பொறிமுறை | பெரிய தொடக்க filters கொண்ட convolutions | சீரான சிறிய convolutions-இன் ஆழமான அடுக்குகள் | Residual skip இணைப்புகள் + BatchNorm | படத் துண்டுகள் மீது self-attention |
| ஆழம் (கற்கும் அடுக்குகள்) | 8 | 16 | 50 | 12 முதல் 32+ transformer தொகுதிகள் |
| Filter / Patch அளவு | 11×11, 5×5, 3×3 | முழுமையாக 3×3 | 7×7 தொடக்கம், பின்னர் 1×1 மற்றும் 3×3 | 16×16 பிக்சல் துண்டுகள் (convolutions இல்லை) |
| அளவுருக்கள் | ~62.4 மில்லியன் | ~138 மில்லியன் | ~25.6 மில்லியன் | ~86 மில்லியன் (ViT-Base) |
| ImageNet Top-5 பிழை | 15.3% | 7.3% | 3.57% | < 1.5% (முன்-பயிற்சியுடன்) |
| முக்கிய புதுமை | ஆழ்ந்த CNN + ReLU + GPU-க்கள் அளவில் விரிவடையும் என நிரூபித்தது | அடுக்கிய 3×3 filters குறைந்த அளவுருக்களுடன் பெரிய receptive field-களுக்கு இணையாகும் எனக் காட்டியது | Identity shortcuts மூலம் vanishing gradients-ஐத் தீர்த்து, 100+ அடுக்குகளை சாத்தியமாக்கியது | இடஞ்சார்ந்த inductive bias-ஐ நீக்கி, படங்களை tokens-இன் தொடர்களாகக் கருதுகிறது |
- VGG பெரிய filters-ஐ ஏன் மாற்றியது: இரண்டு அடுக்கிய 3×3 filters ஒரு 5×5 filter-இன் அதே receptive field-ஐயும், மூன்று அடுக்கிய 3×3 filters 11×11 பரப்பையும் உள்ளடக்குகின்றன—அதே நேரத்தில் கூடுதல் ReLU non-linearities-ஐ அறிமுகப்படுத்தி, மிகக் குறைவான அளவுருக்களையே பயன்படுத்துகின்றன.
- ResNet அளவுருப் பெருக்கத்தை ஏன் குறைத்தது: AlexNet-இன் மிகப்பெரிய fully connected அடுக்குகளை (FC6, FC7) ResNet Global Average Pooling-ஆல் மாற்றி, 8 அடுக்குகளிலிருந்து 50+ அடுக்குகளுக்குச் செல்லும்போதும் அளவுருக்களின் எண்ணிக்கையைப் பாதிக்கும் மேல் குறைத்தது.
- ViT முன்னுதாரணத்தை எப்படி மாற்றியது: Vision Transformers convolutions-ஐ முற்றிலுமாகக் கைவிட்டு, படங்களைத் தட்டையான துண்டுகளாகப் பிரித்து, Large Language Models-இல் பயன்படுத்தப்படும் அதே Transformer attention பொறிமுறையைப் பயன்படுத்தின.
3. நவீன PyTorch செயலாக்கம்
நவீன சிறந்த நடைமுறைகளைப் பயன்படுத்தும் (Conv1-இல் சரிசெய்யப்பட்ட padding உடனான நிலையான 224 × 224 உள்ளீடுகள், நெகிழ்வான உள்ளீட்டுத் தெளிவுத்திறனை மாதிரி ஏற்க Adaptive Average Pooling போன்றவை) AlexNet-இன் தூய்மையான, தனித்து இயங்கும் PyTorch செயலாக்கம் கீழே உள்ளது.
import torch
import torch.nn as nn
import torch.optim as optim

class AlexNet(nn.Module):
    def __init__(self, num_classes: int = 1000, dropout: float = 0.5):
        super().__init__()

        # Feature extractor (5 Convolutional layers)
        self.features = nn.Sequential(
            # Conv1: 224x224x3 -> 55x55x64 (Modern PyTorch standard uses 64 filters & pad=2)
            nn.Conv2d(3, 64, kernel_size=11, stride=4, padding=2),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Conv2: 27x27x64 -> 27x27x192
            nn.Conv2d(64, 192, kernel_size=5, padding=2),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Conv3: 13x13x192 -> 13x13x384
            nn.Conv2d(192, 384, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),

            # Conv4: 13x13x384 -> 13x13x256
            nn.Conv2d(384, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),

            # Conv5: 13x13x256 -> 13x13x256 -> Pool -> 6x6x256
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),
        )

        # Ensures output is always 6x6 regardless of slight input image size variations
        self.avgpool = nn.AdaptiveAvgPool2d((6, 6))

        # Classifier (3 Fully Connected layers)
        self.classifier = nn.Sequential(
            nn.Dropout(p=dropout),
            nn.Linear(256 * 6 * 6, 4096),
            nn.ReLU(inplace=True),

            nn.Dropout(p=dropout),
            nn.Linear(4096, 4096),
            nn.ReLU(inplace=True),

            nn.Linear(4096, num_classes),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x


# --- Quick Training Loop Example ---
if __name__ == "__main__":
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    # Instantiate for a 10-class dataset (e.g., CIFAR-10 upscaled or Imagenette)
    model = AlexNet(num_classes=10).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.AdamW(model.parameters(), lr=1e-4, weight_decay=1e-2)

    # Dummy batch: 8 RGB images of size 224x224
    dummy_images = torch.randn(8, 3, 224, 224, device=device)
    dummy_labels = torch.randint(0, 10, (8,), device=device)

    # Single forward + backward training step
    model.train()
    optimizer.zero_grad()
    outputs = model(dummy_images)
    loss = criterion(outputs, dummy_labels)
    loss.backward()
    optimizer.step()

print(f"Device: {device} | Output shape: {outputs.shape} | Step loss: {loss.item():.4f}")- குறியீட்டில் நவீன மாற்றங்கள்: நிலையான torchvision.models.alexnet, மூலக் கட்டுரையின் பிரிக்கப்பட்ட-GPU எண்ணிக்கைகளுக்குப் (96, 256, 384, 384, 256) பதிலாக சற்று எளிமைப்படுத்தப்பட்ட channel எண்ணிக்கைகளையும் (64, 192, 384, 256, 256), சிறிய தரவுத்தொகுப்புகளில் விரைவான ஒருங்கிணைவுக்காக momentum உடனான SGD-க்குப் பதிலாக AdamW-ஐயும் பயன்படுத்துகிறது.
- Transfer Learning குறுக்குவழி: புதிதாகப் பயிற்றுவிப்பதற்குப் பதிலாக முன்-பயிற்சி பெற்ற AlexNet-ஐ fine-tune செய்ய விரும்பினால், torchvision.models.alexnet(weights="DEFAULT") மூலம் நேரடியாக ஏற்றி, model.classifier[6] = nn.Linear(4096, your_num_classes) எனப் பதிலீடு செய்யலாம்.