AlexNet விளக்கம்: ஆழ்ந்த கற்றல் புரட்சியைத் தொடங்கிய 2012-ஆம் ஆண்டின் ஆழ்ந்த convolutional நரம்பியல் வலையமைப்பு
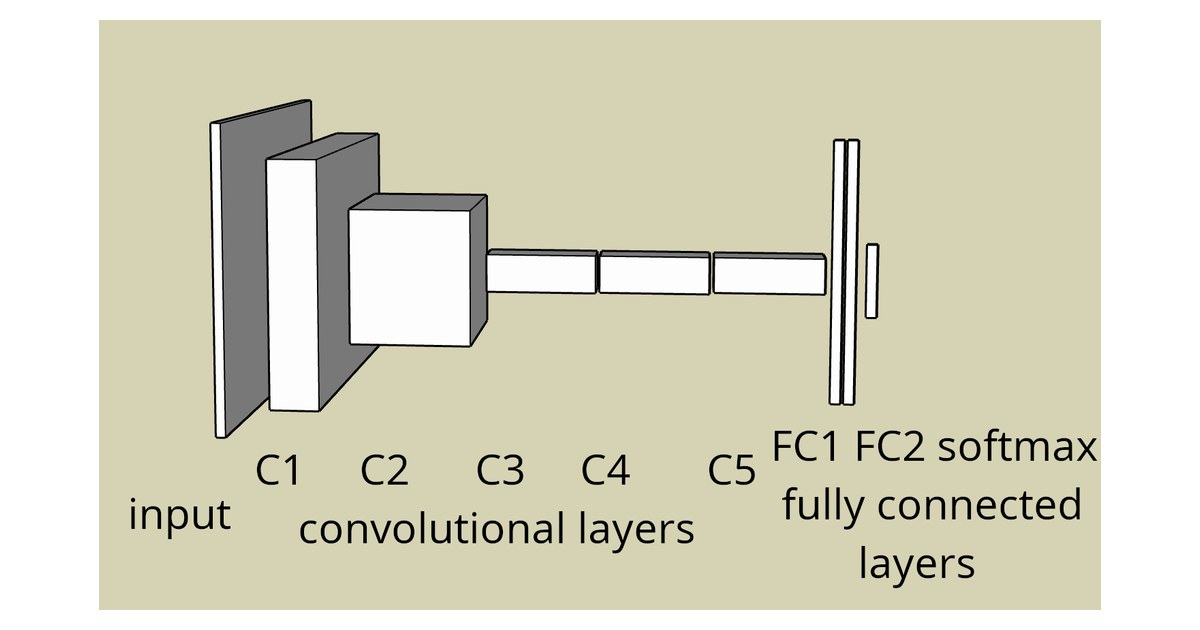
விளக்கப்படம்: AlexNet block diagram: five convolutional layers, then fully connected layers and a softmax output. படம்: Trebol6, CC BY-SA 4.0, via Wikimedia Commons.
AlexNet என்பது 2012-இல் அறிமுகமான, நவீன ஆழ்ந்த கற்றல் (deep learning) புரட்சியைத் தொடங்கி வைத்த ஒரு முக்கிய ஆழ்ந்த convolutional neural network (CNN) ஆகும். டொராண்டோ பல்கலைக்கழகத்தில் Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton ஆகியோர் உருவாக்கிய இந்த மாதிரி, 2012 செப்டம்பர் 30 அன்று ImageNet Large Scale Visual Recognition Challenge போட்டியில் வென்று, பட அடையாளக் காணல் அளவுகோல்களை முறியடித்தது.
இது ஏன் ஒரு திருப்புமுனை
2012-க்கு முன், கணினிப் பார்வை (computer vision) கைமுறையாக வடிவமைக்கப்பட்ட அம்சங்களையும் பாரம்பரிய இயந்திரக் கற்றல் வகைப்படுத்திகளையும் நம்பியிருந்தது. நவீன வன்பொருளுடன் இணைந்தால், பெரிய தரவுத்தொகுப்புகளிலிருந்து காட்சி அம்சங்களை ஆழ்ந்த நரம்பியல் வலையமைப்புகள் தாமாகவே கற்றுக்கொள்ள முடியும் என்பதை AlexNet நிரூபித்தது.
- மிகப்பெரிய துல்லிய முன்னேற்றம். 1.2 மில்லியன் படங்கள் மற்றும் 1,000 பொருள் வகைகளில் AlexNet 15.3% top-5 பிழை விகிதத்தை எட்டியது. இது இரண்டாம் இடம் பெற்ற பதிவை (26.2%) 10.8 சதவீதப் புள்ளிகளுக்கு மேல் முந்தியது.
- AI-யில் முன்னுதாரண மாற்றம். வலையமைப்பின் ஆழத்தை அதிகரிப்பது செயல்திறனைக் கணிசமாக மேம்படுத்தும் என்பதை இதன் வெற்றி நிரூபித்தது. இது கணினிப் பார்வை, இயற்கை மொழி செயலாக்கம், generative AI ஆகிய துறைகளில் விரைவான வளர்ச்சியைத் தூண்டியது.
முக்கிய தொழில்நுட்பப் புதுமைகள்
சுமார் 60 மில்லியன் அளவுருக்கள் (parameters), 650,000 நியூரான்கள் கொண்ட மாபெரும் வலையமைப்பை overfitting அல்லது தேக்கம் இல்லாமல் பயிற்றுவிக்க, ஆழ்ந்த கற்றலில் பின்னர் நிலையான நடைமுறைகளாக மாறிய பல நுட்பங்களை குழு அறிமுகப்படுத்தியது:
- இரட்டை GPU பயிற்சி. இந்த மாதிரி ஒரு சாதாரண வரைகலை அட்டையின் நினைவகத்தில் பொருந்தாத அளவு பெரியதாக இருந்தது. Krizhevsky வலையமைப்பை இரண்டு NVIDIA GPU-களுக்கு இடையே பிரித்து, அவற்றின் இணைச் செயலாக்க மையங்களைப் பயன்படுத்தி, பயிற்சி நேரத்தை ஐந்து அல்லது ஆறு நாட்களாகக் குறைத்தார்.
- ReLU செயல்படுத்தல் சார்புகள். tanh அல்லது sigmoid போன்ற பாரம்பரிய saturating சார்புகளுக்குப் பதிலாக, AlexNet Rectified Linear Units (ReLU) பயன்படுத்தியது. இது vanishing gradients-ஐத் தடுத்து, வலையமைப்பை பல மடங்கு வேகமாகப் பயிற்றுவிக்க உதவியது.
- Dropout regularization. பயிற்சியின்போது, முழுமையாக இணைக்கப்பட்ட அடுக்குகளில் உள்ள நியூரான்களில் 50%-ஐ வலையமைப்பு சீரற்ற முறையில் செயலிழக்கச் செய்தது. இதனால் பயிற்சிப் படங்களை மனப்பாடம் செய்யாமல், மிகைத்தன்மை கொண்ட உறுதியான அம்சங்களை மாதிரி கற்றுக்கொண்டது.
- Data augmentation. சீரற்ற படத் துண்டிப்புகள் (crops), கிடைமட்டப் புரட்டல்கள், RGB நிறச் செறிவு மாற்றங்கள் ஆகியவற்றைப் பயன்படுத்தி, பயிற்சித் தொகுப்பை குழு செயற்கையாக விரிவுபடுத்தியது.
- Overlapping pooling. ஒன்றோடொன்று மேற்படாத pooling சாளரங்களைப் பயன்படுத்திய முந்தைய வலையமைப்புகளைப் போலன்றி, AlexNet மேற்படியும் max-pooling அடுக்குகளைப் பயன்படுத்தி, இடஞ்சார்ந்த அமைப்பை சிறப்பாகப் பாதுகாத்து, பிழை விகிதத்தைக் குறைத்தது.
கட்டமைப்பு மேலோட்டம்
AlexNet மொத்தம் 8 கற்கும் அடுக்குகளைக் கொண்டுள்ளது:
- 5 Convolutional அடுக்குகள். இந்த அடுக்குகள் sliding filters-ஐப் (பெரிய 11×11 filters-உடன் தொடங்கி) பயன்படுத்தி, குறைந்த நிலை விளிம்புகள், அமைப்புகளைப் பிரித்தெடுத்து, சிக்கலான பொருள் பகுதிகள் வரை முன்னேறுகின்றன.
- 3 Fully connected அடுக்குகள். இந்த அடர்த்தியான அடுக்குகள் பிரித்தெடுத்த காட்சி அம்சங்களை இணைத்துப் படத்தை வகைப்படுத்துகின்றன; ஒவ்வொரு ImageNet வகைக்கும் நிகழ்தகவுகளை ஒதுக்கும் 1,000-வழி softmax வெளியீட்டு அடுக்குடன் முடிகின்றன.
2012-ஆம் ஆண்டின் மூல மாதிரியின் வரலாற்று மூலக் குறியீடு பின்னர் Computer History Museum மூலம் பாதுகாக்கப்பட்டு, திறந்த முறையில் வெளியிடப்பட்டது.