ஆழ்கற்றல் கணினிப் பார்வை வரலாறு: AlexNet முதல் பன்முக மாதிரிகள் வரை
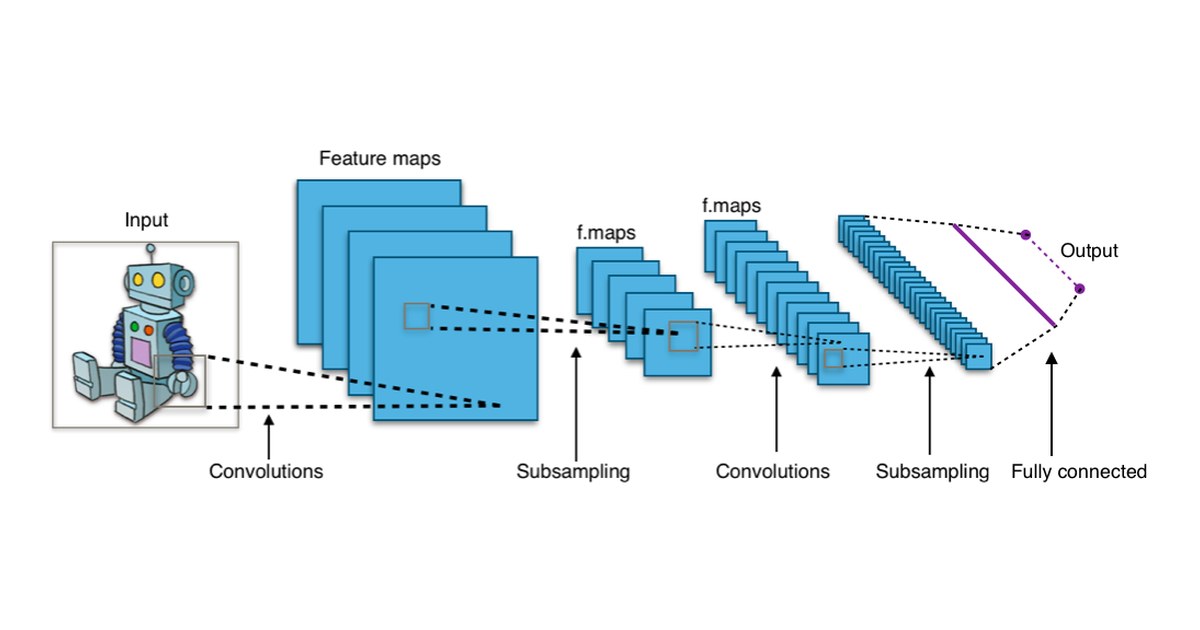
விளக்கப்படம்: Typical convolutional network: input image, convolution and subsampling stages, fully connected output; illustrative of the computer-vision pipeline. படம்: Aphex34, CC BY-SA 4.0, via Wikimedia Commons.
ஆழ்கற்றல் (Deep Learning) கணினிப் பார்வை (Computer Vision) வரலாறு 2012-ஆம் ஆண்டு AlexNet-உடன் தொடங்கி, இன்று நாம் பயன்படுத்தும் பன்முக (Multimodal) மாதிரிகள் வரை நான்கு முக்கியக் காலகட்டங்களாக வளர்ச்சியடைந்துள்ளது. GPU-க்களில் பயிற்சி அளிக்கப்பட்ட ஆழமான நரம்பியல் வலையமைப்புகள் (Neural Networks) மனிதர்களால் உருவாக்கப்பட்ட பழைய அல்காரிதம்களை விடச் சிறப்பாகச் செயல்படும் என்பதை AlexNet நிரூபித்தது.
1. பாரம்பரிய CNN காலகட்டம் (2012–2014)
ஆரம்பகட்ட ஆராய்ச்சிகள் வலையமைப்புகளை மேலும் ஆழமாக்குவதிலும் (Deeper), AlexNet-இன் பெரிய ஃபில்டர் (Filter) அளவுகளைச் சரிசெய்வதிலும் கவனம் செலுத்தின.
- AlexNet (2012). 8 அடுக்குகளுடன் (Layers) ReLU, Dropout மற்றும் இரட்டை GPU பயிற்சியை அறிமுகப்படுத்தியது. பெரிய படத் தொகுப்புகளில் ஆழ்கற்றல் சிறப்பாகச் செயல்படும் என்பதை இது நிரூபித்தது.
- ZFNet (2013). AlexNet-இன் முதல் அடுக்கிலிருந்த 11×11 ஃபில்டரை 7×7 ஆகவும், நகரும் அளவை (Stride) 4-லிருந்து 2-ஆகவும் குறைத்து மேம்படுத்தியது. இது படங்களின் நுணுக்கமான விவரங்களைத் தக்கவைக்க உதவியது.
- VGGNet (2014). பெரிய ஃபில்டர்களுக்குப் பதிலாக, சிறிய 3×3 கன்வல்யூஷன் (Convolutions) அடுக்குகளை ஒன்றன் பின் ஒன்றாக 19 அடுக்குகள் வரை அடுக்கியது. துல்லியத்திற்கு வலையமைப்பின் ஆழம் மிக முக்கியம் என்பதை இது காட்டியது.
- GoogLeNet / Inception (2014). ஒரே அடுக்கிற்குள் 1×1, 3×3 மற்றும் 5×5 ஃபில்டர்களை இணையாக (Parallel) இயக்கும் Inception தொகுதிகளை அறிமுகப்படுத்தியது. VGG-ஐ விட மிகக் குறைவான அளவுருக்களுடன் (Parameters) அதிகத் துல்லியத்தை இது வழங்கியது.
2. அதி-ஆழமான மற்றும் எச்ச அடுக்குகள் காலகட்டம் (2015–2017)
வலையமைப்புகள் 20 அடுக்குகளைத் தாண்டியபோது, பயிற்சியின் போது சாய்வுகள் மறைந்து (Vanishing Gradients) துல்லியம் குறையத் தொடங்கியது. அடுக்குகளுக்கு இடையே தகவல் பாயும் விதத்தை மாற்றியமைப்பதன் மூலம் ஆராய்ச்சியாளர்கள் இதற்குத் தீர்வு கண்டனர்.
- ResNet (2015). தகவல்கள் சில அடுக்குகளைத் தாண்டி நேரடியாகச் செல்ல உதவும் Residual Skip Connections முறையை அறிமுகப்படுத்தியது. இதன் மூலம் 50, 101 மற்றும் 1,000-க்கும் மேற்பட்ட அடுக்குகளைக் கொண்ட மாதிரிகளை எளிதாகப் பயிற்றுவிக்க முடிந்தது.
- DenseNet (2017). ஒரு தொகுதிக்குள் இருக்கும் ஒவ்வொரு அடுக்கையும் அதற்குப் பின்வரும் அனைத்து அடுக்குகளுடனும் நேரடியாக இணைத்தது. இது அம்சங்களை (Features) மீண்டும் பயன்படுத்துவதை அதிகரித்து, அளவுருக்களின் எண்ணிக்கையைக் குறைத்தது.
3. மொபைல் மற்றும் செயல்திறன் காலகட்டம் (2017–2019)
கணினிகளில் மனிதர்களுக்கு இணையான துல்லியத்தை எட்டிய பிறகு, ஸ்மார்ட்போன்கள் மற்றும் சிறிய சாதனங்களில் இயங்கும் வகையில் மாதிரிகளின் அளவைச் சுருக்குவதில் கவனம் திரும்பியது.
- MobileNet (2017). சாதாரண கன்வல்யூஷன்களுக்குப் பதிலாக Depthwise Separable Convolutions முறையைப் பயன்படுத்தி, மொபைல் சாதனங்களுக்கான கணக்கீட்டுச் செலவைப் பெருமளவில் குறைத்தது.
- EfficientNet (2019). வலையமைப்பின் ஆழம், அகலம் மற்றும் படத்தின் தெளிவுத்திறன் (Resolution) ஆகிய மூன்றையும் சமநிலையில் அதிகரிக்கும் Compound Scaling முறையை அறிமுகப்படுத்தியது.
4. விஷன் டிரான்ஸ்ஃபார்மர் மற்றும் நவீன காலகட்டம் (2020–தற்போது வரை)
இயற்கை மொழிச் செயலாக்கத்தில் (NLP) ஏற்பட்ட புரட்சியால் ஈர்க்கப்பட்டு, ஆராய்ச்சியாளர்கள் கன்வல்யூஷன் முறைகளிலிருந்து கவனம் சார்ந்த (Attention-based) மாதிரிகளுக்கு மாறத் தொடங்கினர்.
- Vision Transformer / ViT (2020). படங்களை 16×16 பிக்சல் துண்டுகளாகப் (Patches) பிரித்து, கன்வல்யூஷன்களை முழுமையாக நீக்கிவிட்டு Transformer Self-Attention மூலம் செயலாக்கியது.
- Swin Transformer (2021). படிநிலை அமைப்பு (Hierarchical structure) மற்றும் நகரும் சாளரங்களை (Shifted Windows) ViT-க்குள் கொண்டு வந்தது. இது பொருட்களைக் கண்டறிதல் (Object Detection) போன்ற பணிகளுக்கு மிகவும் பயனுள்ளதாக அமைந்தது.
- ConvNeXt (2022). டிரான்ஸ்ஃபார்மர்களின் வடிவமைப்பு நுணுக்கங்களைப் பயன்படுத்தி ResNet-ஐ நவீனப்படுத்தியது. தூய CNN மாதிரிகளாலும் ViT-க்கு இணையான துல்லியத்தை எட்ட முடியும் என்பதை இது நிரூபித்தது.
- பன்முக மாதிரிகள் / Multimodal Models (2021–தற்போது வரை). CLIP, SAM (Segment Anything) மற்றும் நவீன Multimodal LLM-கள் படங்களையும் எழுத்துக்களையும் ஒரே மாதிரியில் இணைக்கின்றன. இதனால் படங்கள், உரை மற்றும் வீடியோக்களை ஒரே நேரத்தில் புரிந்துகொள்ள முடிகிறது.