செயற்கை நரம்பணுக்களிலிருந்து AlexNet மற்றும் அதற்கு அப்பால்: ஆழ்கற்றலின் உருவாக்கமும் CUDA-வுடனான தொடர்பும்
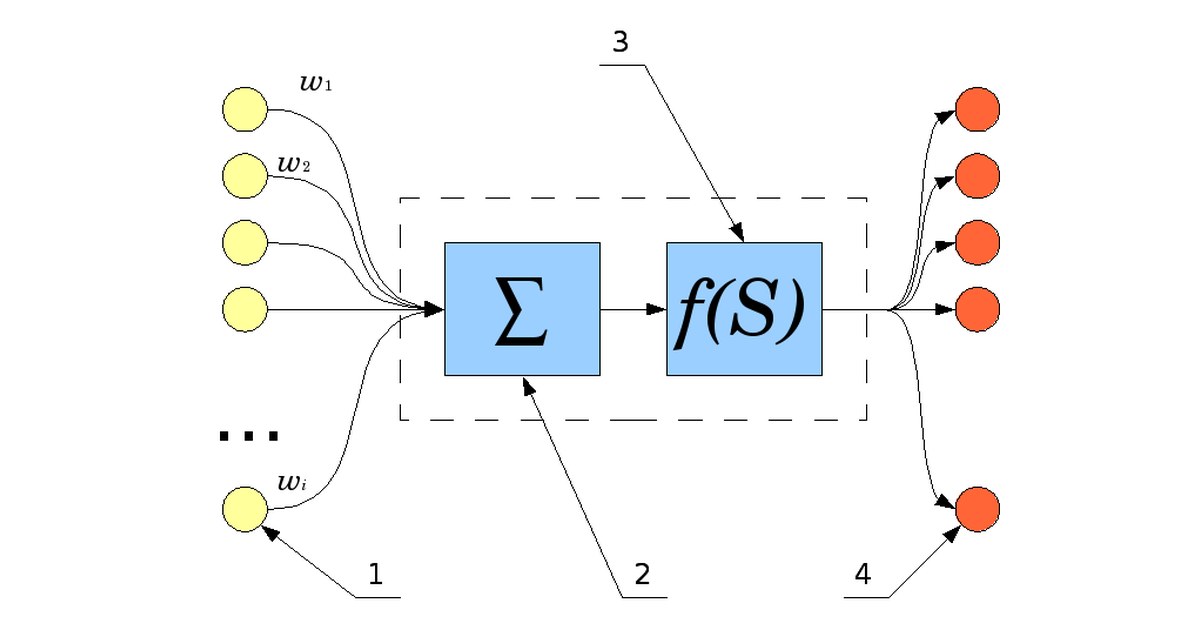
விளக்கப்படம்: Scheme of an artificial neuron: weighted inputs, a summation and an activation function f(S). படம்: Lightning13, public domain, via Wikimedia Commons.
சுருக்கம்
இன்றைய செயற்கை நுண்ணறிவின் வெற்றி ஒரே ஒரு கண்டுபிடிப்பிலிருந்து உருவாகவில்லை. செயற்கை நரம்பணுக்கள், கற்றல் வழிமுறைகள், கன்வல்யூஷன் வலையமைப்புகள், தொடர் தரவுகளுக்கான மாதிரிகள் ஆகியவற்றில் பல தசாப்தங்களாக மேற்கொள்ளப்பட்ட ஆய்வுகளும், பெரிய தரவுத்தொகுப்புகளும், வேகமான கணினித் திறனும் இணைந்ததன் விளைவாக அது உருவானது.
NVIDIA-வின் CUDA, அதன் GPU-களில் பொதுநோக்கு இணைக் கணக்கீடுகளைச் செய்வதை ஆராய்ச்சியாளர்களுக்கு எளிதாக்கியது. 2012-இல் AlexNet, ஏற்கெனவே இருந்த பல முன்னேற்றங்களை இணைத்து, ImageNet பட வகைப்பாட்டுப் போட்டியில் குறிப்பிடத்தக்க முடிவைப் பெற்றது.
இந்தக் கட்டுரை நரம்பியல் வலையமைப்புகள், ஆழ்கற்றல், GPU, CUDA மற்றும் AlexNet ஆகியவற்றுக்கிடையிலான தொடர்பை விளக்குகிறது. அதன் பின்னர் CNN-கள், Transformer-கள் மற்றும் பன்முக மாதிரிகள் வரை கணினிப் பார்வை எவ்வாறு வளர்ந்தது என்பதையும் ஆராய்கிறது.
முக்கியத் திருத்தம்: ஆழ்கற்றலும் கணினிப் பார்வையும் 2012-இல் AlexNet-உடன் தொடங்கவில்லை. பல தசாப்த கால ஆராய்ச்சியின் அடிப்படையில் உருவான ஒரு முக்கியத் திருப்புமுனையே AlexNet ஆகும்.
1. இவற்றுக்கிடையிலான அடிப்படைத் தொடர்பு
- செயற்கை நரம்பியல் வலையமைப்பு (Artificial Neural Network): மாற்றியமைக்கக்கூடிய அளவுருக்களைக் கொண்ட, ஒன்றோடொன்று இணைக்கப்பட்ட கணக்கீட்டு அலகுகளாலான கணித மாதிரி.
- ஆழ்கற்றல் (Deep Learning): பல அடுக்குகளைக் கொண்ட மாதிரிகளில் தரவுகளின் பிரதிநிதித்துவங்களைக் கற்றுக்கொள்ளச் செய்யும் முறைகள்.
- கன்வல்யூஷன் நரம்பியல் வலையமைப்பு (CNN): படங்கள் போன்ற இடவியல் தரவுகளுக்குப் பயனுள்ள, கற்றுக்கொள்ளப்பட்ட வடிகட்டிகளைப் பயன்படுத்தும் கட்டமைப்பு.
- GPU: ஒரே நேரத்தில் பல கணக்கீடுகளைச் செய்ய வடிவமைக்கப்பட்ட செயலி.
- CUDA: NVIDIA GPU-களில் பொதுநோக்குக் கணக்கீடுகளைச் செய்ய உதவும் NVIDIA-வின் தளமும் நிரலாக்க மாதிரியும்.
- ImageNet: படத் தரவுத்தொகுப்பு மற்றும் அதனுடன் தொடர்புடைய மதிப்பீட்டு அமைப்பு.
- AlexNet: ImageNet போட்டியில் முக்கியமான சாதனையை நிகழ்த்திய ஒரு குறிப்பிட்ட ஆழமான CNN மற்றும் பயிற்சி அமைப்பு.
இதனைச் சுருக்கமாகப் பின்வருமாறு புரிந்துகொள்ளலாம்:
ஆராய்ச்சி மாதிரிகளையும் கற்றல் முறைகளையும் வழங்கியது → தரவுகள் எடுத்துக்காட்டுகளை வழங்கின → GPU இணைக் கணக்கீட்டுத் திறனை வழங்கியது → NVIDIA GPU-களை நிரலாக்க CUDA உதவியது → இவற்றை AlexNet ஒரு முக்கியச் சோதனையில் இணைத்தது.
இது வரலாற்று ஆதாரங்களின் அடிப்படையிலான தொகுப்பாகும். இவற்றில் ஏதேனும் ஒன்று மட்டுமே வெற்றிக்குப் போதுமானது என்பது இதன் பொருளல்ல.
2. 1943–1958: ஆரம்பகால செயற்கை நரம்பணுக்கள்
1943-இல் வாரன் மெக்கல்லாக் (Warren McCulloch), வால்டர் பிட்ஸ் (Walter Pitts) ஆகியோர் தர்க்கவியலைப் பயன்படுத்தி எளிமைப்படுத்தப்பட்ட நரம்பணுவின் கணித மாதிரியை விவரித்தனர். எளிய அலகுகளின் வலையமைப்புகள் சிக்கலான கணக்கீடுகளைக் குறிக்க முடியும் என்ற சிந்தனைக்கு இது அடித்தளமிட்டது. இது ஒரு நவீன தரவுப் பயிற்சி பெற்ற வலையமைப்போ அல்லது மனித மூளையின் முழுமையான மாதிரியோ அல்ல. McCulloch and Pitts, 1943
1958-இல் ஃபிராங்க் ரோசன்பிளாட் (Frank Rosenblatt), வடிவங்களை அடையாளம் காணக் கற்றுக்கொள்ளும் பெர்செப்ட்ரான் (Perceptron) அமைப்பை விவரித்தார். ஒவ்வொரு வகைப்பாட்டு விதியையும் நிரலாக்குவதற்குப் பதிலாக, எடுத்துக்காட்டுகளின் அடிப்படையில் அமைப்பின் அளவுருக்களை மாற்ற முடியும் என்பதே இதன் முக்கிய எண்ணமாகும். Rosenblatt, 1958
எளிமையாக ஒரு செயற்கை நரம்பணுவை இவ்வாறு குறிப்பிடலாம்:
வெளியீடு = செயல்பாட்டு மாற்றம் (எடையிடப்பட்ட உள்ளீடுகள் + bias)
ஒவ்வொரு உள்ளீட்டின் செல்வாக்கையும் அதன் எடை (Weight) பாதிக்கிறது. செயல்பாட்டு மாற்றம் (Activation function), மேலும் சிக்கலான தொடர்புகளை மாதிரி பிரதிநிதித்துவப்படுத்த உதவுகிறது.
3. 1980–1998: படிநிலைப் பார்வையும் மறைந்த அம்சங்களின் கற்றலும்
நியோகாக்னிட்ரான் (Neocognitron)
1980-இல் குனிஹிகோ ஃபுகுஷிமா (Kunihiko Fukushima), காட்சிப் படிமங்களை அடையாளம் காணும் படிநிலை மாதிரியான Neocognitron-ஐ முன்மொழிந்தார். பொருளின் இடம் மாறினாலும் அதன் வடிவத்தை அடையாளம் காணும் நோக்கத்துடன் உருவாக்கப்பட்ட இது, பின்னர் வந்த CNN-களுக்கு முக்கிய முன்னோடியாக இருந்தது. இதன் ஆரம்பகால கற்றல் முறை, AlexNet பயன்படுத்திய supervised backpropagation முறைக்கு நேரடியாகச் சமமானதல்ல. Fukushima, 1980
பின்னோக்கிப் பிழைப் பரப்பல் (Backpropagation)
பல அடுக்குகளைக் கொண்ட வலையமைப்பின் மறைந்த அடுக்குகளில் உள்ள அளவுருக்களை எவ்வாறு சரிசெய்வது என்பது ஒரு முக்கியச் சவாலாக இருந்தது.
1986-இல் டேவிட் ருமெல்ஹார்ட், ஜெஃப்ரி ஹிண்டன், ரொனால்ட் வில்லியம்ஸ் ஆகியோர், Backpropagation மூலம் பயனுள்ள உள் பிரதிநிதித்துவங்களைக் கற்றுக்கொள்ள முடியும் என்பதை விளக்கும் செல்வாக்கு மிக்க ஆய்வை வெளியிட்டனர். இதற்கான முன்னைய பங்களிப்புகளும் இருந்ததால், Backpropagation-இன் ஒவ்வொரு வடிவத்தையும் இவர்கள் முதன்முதலில் கண்டுபிடித்தனர் என்று கூறுவது துல்லியமானதல்ல. Rumelhart, Hinton and Williams, 1986
ஒரு பயிற்சிச் சுற்றை எளிமையாக இவ்வாறு விளக்கலாம்:
- 1. உள்ளீட்டை வழங்கி ஒரு கணிப்பைப் பெறுதல்.
- 2. கணிப்பிலுள்ள பிழையை இழப்புச் சார்பு (Loss function) மூலம் அளவிடுதல்.
- 3. அந்தப் பிழைக்கு ஒவ்வொரு அளவுருவும் எவ்வாறு பங்களித்தது என்பதை Backpropagation மூலம் கணக்கிடுதல்.
- 4. Optimiser மூலம் அளவுருக்களைப் புதுப்பித்தல்.
- 5. பல எடுத்துக்காட்டுகளுடன் இச்செயல்முறையை மீண்டும் செய்தல்.
ஒரு பொதுவான Gradient Descent புதுப்பிப்பு:
புதிய அளவுருக்கள் = பழைய அளவுருக்கள் − கற்றல் விகிதம் × பிழையின் சாய்வு (Gradient)
Backpropagation சாய்வுகளைக் கணக்கிடுகிறது; Optimiser அவற்றைப் பயன்படுத்தி அளவுருக்களை மாற்றுகிறது. இக்கணிதக் கருத்துகள் CUDA-வைச் சார்ந்தவை அல்ல.
LeNet மற்றும் கையெழுத்து எழுத்துக்கள்
1989-இல் யான் லெகுன் (Yann LeCun) மற்றும் அவரது சகாக்கள், கையால் எழுதப்பட்ட அஞ்சல் குறியீடுகளை அடையாளம் காண Backpropagation-ஐப் பயன்படுத்தினர். பின்னர் உருவான LeNet ஆய்வு, ஆவணங்களில் எழுத்துக்களை அடையாளம் காண CNN-கள் பயன்படுவதை எடுத்துக்காட்டியது. எனவே CNN-கள் 2012-க்கு முன்பே நடைமுறைப் பயன்பாட்டில் இருந்தன. LeCun மற்றும் சகாக்கள், 1989; LeNet ஆய்வு, 1998
CNN-களில் உள்ளூர் பகுதிகளை ஆராயும் Local receptive fields மற்றும் பல இடங்களில் மீண்டும் பயன்படுத்தப்படும் Shared filters உள்ளன. இதனால் படத்தின் ஒவ்வொரு இடத்திற்கும் முற்றிலும் தனியான அளவுருக்களைக் கற்றுக்கொள்ளாமல் வடிவங்களைக் கண்டறிய முடிகிறது.
ஆரம்ப அடுக்குகள் எளிய காட்சித் தன்மைகளுக்கும், பின்னைய அடுக்குகள் மேலும் சிக்கலான அம்சங்களுக்கும் பதிலளிக்கலாம். ஒரு அலகு உண்மையில் எதைக் கற்றுக்கொள்கிறது என்பது தரவுகளையும் பயிற்சியையும் சார்ந்தது.
4. கணினிப் பார்வைக்கு அப்பாலும் வளர்ந்த ஆழ்கற்றல்
ஆழ்கற்றலின் வரலாறு பட வகைப்பாட்டு மாதிரிகளின் வரிசை மட்டுமல்ல.
உரை, பேச்சு போன்ற தொடர்ச்சியான தரவுகளுக்காக Recurrent Neural Networks (RNNs) ஆராயப்பட்டன. நீண்டகாலத் தொடர்புகளை Gradient முறைகளால் கற்றுக்கொள்வது ஏன் கடினம் என்பதை 1990-களின் ஆய்வுகள் ஆராய்ந்தன. 1997-இல் செப் ஹோக்ரைட்டர் மற்றும் யூர்கன் ஷ்மிட்ஹூபர் ஆகியோர் Long Short-Term Memory (LSTM) கட்டமைப்பை அறிமுகப்படுத்தினர். Bengio மற்றும் சகாக்கள்; Hochreiter and Schmidhuber, 1997
2006-இல் ஹிண்டன், சைமன் ஒசிண்டெரோ, யீ-வை தே (Yee-Whye Teh) ஆகியோர் Deep Belief Networks-க்கான பயனுள்ள கற்றல் முறையை முன்மொழிந்தனர். இது பல அடுக்கு கற்றலில் மீண்டும் ஆர்வம் அதிகரிக்க உதவியது. ஆனால் இது அனைத்து ஆழமான வலையமைப்புகளின் தொடக்கமோ, AlexNet பயன்படுத்திய அதே பயிற்சி முறையோ அல்ல. Hinton மற்றும் சகாக்கள், 2006
5. GPU ஏன் முக்கியமானது?
நரம்பியல் வலையமைப்புகள் பெருமளவான எண் கணக்கீடுகளைச் செய்கின்றன. உதாரணமாக, ஒரு Dense layer-ஐ இவ்வாறு குறிப்பிடலாம்:
Y = XW + b
பயிற்சியின்போது முன்னோக்கிக் கணக்கீடு, Gradient கணக்கீடு, அளவுருப் புதுப்பிப்பு ஆகியவை பல எடுத்துக்காட்டுகளுக்காக மீண்டும் மீண்டும் நடைபெறுகின்றன. Convolution-களும் கற்றுக்கொள்ளப்பட்ட வடிகட்டிகளைப் படத்தின் பல இடங்களில் பயன்படுத்துகின்றன.
இக்கணக்கீடுகளில் பலவற்றை இணையாக அமைக்க முடியும். அதற்கேற்ற பணிகளில் பல கணக்கீடுகளை ஒரே நேரத்தில் மேற்கொள்ள GPU-கள் உதவின. இருப்பினும் ஒரு GPU எல்லாப் பணிகளிலும் தானாகவே வேகமானது அல்ல; தரவு நகர்வு, நினைவக அணுகல், செயலாக்க முறை மற்றும் வன்பொருள் ஆகியவை முக்கியம்.
GPU ஒரு படத்தை மனிதரைப்போல் “புரிந்துகொள்வதில்லை”. மென்பொருள் குறிப்பிடும் கணக்கீடுகளையே அது செய்கிறது.
6. CUDA வழங்கிய பங்களிப்பு
NVIDIA 2006-இல் CUDA-வை அறிமுகப்படுத்தியது; CUDA 1.0 2007-இல் பொதுவாக வெளியிடப்பட்டது. NVIDIA GPU-களில் பொதுநோக்குக் கணக்கீடுகளை இயக்குவதற்கான தளத்தையும் நிரலாக்க மாதிரியையும் CUDA வழங்குகிறது. NVIDIA CUDA அறிமுகம்; CUDA 1.0 வெளியீடு
வரலாற்று ரீதியாக, Graphics-ஐ மையமாகக் கொண்ட இடைமுகங்கள் வழியாகக் கணக்கீடுகளைச் செய்வதைவிட, GPU-களில் பொதுவான எண் கணக்கீடுகளை நிரலாக்குவது இதனால் எளிதானது.
CUDA நரம்பியல் வலையமைப்புகளையோ Backpropagation-ஐயோ Deep Learning-ஐயோ கண்டுபிடிக்கவில்லை. NVIDIA வன்பொருளில் பொருத்தமான கணக்கீடுகளைச் செயல்படுத்தவும் வேகப்படுத்தவும் ஆராய்ச்சியாளர்களுக்கு அது உதவியது. CPU-களிலும் வேறு வகைச் செயலிகளிலும் பிற மென்பொருள் அமைப்புகளைக் கொண்டு நரம்பியல் வலையமைப்புகளைப் பயிற்றுவிக்க முடியும்.
AlexNet-க்கு முன்னரே GPU ஆழ்கற்றல் இருந்தது
2009-இல் ரெய்னா, மாதவன், ஆண்ட்ரூ இங் ஆகியோர் GPU-களைப் பயன்படுத்திய பெரிய அளவிலான ஆழ்கற்றல் ஆய்வை வெளியிட்டனர். சிரேஷன் மற்றும் சகாக்களும் 2011-க்குள் GPU அடிப்படையிலான CNN காட்சிப் பகுப்பாய்வு ஆய்வை வெளியிட்டிருந்தனர். எனவே AlexNet தான் முதல் GPU-பயிற்சி பெற்ற நரம்பியல் வலையமைப்பு என்று கூற முடியாது. Raina மற்றும் சகாக்கள், 2009; Cireșan மற்றும் சகாக்கள், 2011
7. ImageNet: தரவும் பொதுவான மதிப்பீடும்
ஒரு வலுவான கற்றல் முறைக்கு ஏற்ற தரவுகளும் முன்னேற்றத்தை மதிப்பிடும் வழியும் அவசியம். 2009-இல் அறிமுகப்படுத்தப்பட்ட ImageNet, கருத்தியல் படிநிலையின் அடிப்படையில் ஒழுங்குபடுத்தப்பட்ட பெரிய படத் தரவுத்தொகுப்பை வழங்கியது. ILSVRC போட்டி, இந்த விரிவான அமைப்பில் வரையறுக்கப்பட்ட பணிகளையும் துணைத் தரவுத்தொகுப்புகளையும் பயன்படுத்தியது. ImageNet ஆய்வு
ImageNet-இன் முக்கியத்துவம் படங்களின் எண்ணிக்கை மட்டுமல்ல. பல்வேறு முறைகளை ஒப்பிட உதவும் கடினமான பொதுவான மதிப்பீட்டுத் தளத்தையும் அது வழங்கியது.
ஆனால் ஒரு போட்டியில் சிறப்பாகச் செயல்படுவது, எல்லா நிஜ உலகச் சூழல்களிலும் நம்பகமான புரிதல் உள்ளது என்பதற்குச் சான்றல்ல.
8. 2012 AlexNet: ஒரு முக்கியத் திருப்புமுனை
Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton ஆகியோர் AlexNet-ஐ உருவாக்கினர். ஏறத்தாழ 60 மில்லியன் அளவுருக்களைக் கொண்ட இம்மாதிரியில் எட்டு கற்றுக்கொள்ளக்கூடிய அடுக்குகள் இருந்தன: ஐந்து Convolutional layers மற்றும் மூன்று Fully connected layers.
பெரிய அளவிலான பெயரிடப்பட்ட தரவு, GPU கணக்கீடு, ReLU, தரவுப் பெருக்கம் (Data augmentation), Dropout மற்றும் திறமையான செயலாக்கம் ஆகியவற்றை இது இணைத்தது. தலா 3 GB நினைவகம் கொண்ட இரண்டு NVIDIA GTX 580 GPU-களில் சுமார் ஐந்து முதல் ஆறு நாட்கள் பயிற்சி நடைபெற்றதாக ஆய்வாளர்கள் தெரிவித்தனர். நினைவக வரம்பும் வலையமைப்பை இரண்டு GPU-களுக்கு இடையே பிரித்தமைக்கான காரணங்களில் ஒன்றாக இருந்தது. AlexNet அசல் ஆய்வுக் கட்டுரை
2012 போட்டியில் சமர்ப்பிக்கப்பட்ட மாதிரிகளின் கூட்டமைப்பு 15.3% Top-five error பெற்றது; அடுத்த சிறந்த போட்டியாளர் 26.2% பெற்றார். Top-five error என்பது சரியான வகை, மாதிரி அதிக வாய்ப்புள்ளதாகக் குறிப்பிட்ட ஐந்து வகைகளுக்குள் இடம்பெறாத நிலையாகும். போட்டியின் இம்முடிவை எல்லாத் தனிப்பட்ட AlexNet மாதிரிகளுக்கும் பொதுவாகப் பொருத்தக் கூடாது.
AlexNet கண்டுபிடிக்காதவை
CNN, ReLU, Dropout, Backpropagation அல்லது GPU பயிற்சி ஆகியவற்றை AlexNet முதன்முதலில் கண்டுபிடிக்கவில்லை. ஏற்கெனவே இருந்த நுட்பங்களைப் பெரிய அளவில் திறமையாக இணைத்து, குறிப்பிடத்தக்க முடிவை நிரூபித்ததே அதன் முக்கியத்துவமாகும். உதாரணமாக ReLU பற்றிய ஆய்வு AlexNet-க்கு முன்பே வெளிவந்தது. Nair and Hinton, 2010
கிரிசெவ்ஸ்கியின் ஆய்வுப் பக்கம், இந்த ஆராய்ச்சித் தொடருடன் தொடர்புடைய CUDA அடிப்படையிலான CNN மென்பொருளைக் குறிப்பிடுகிறது. AlexNet-இன் அசல் ஆய்வு, பின்னர் உருவான cuDNN-க்கு முந்தையது. எனவே அசல் AlexNet பயிற்சி cuDNN-ஐப் பயன்படுத்தியது என்று கூறக்கூடாது. Krizhevsky-யின் ஆய்வுப் பக்கம்; cuDNN ஆய்வு, 2014
வரலாற்றுப் பாடம்: AlexNet ஆழ்கற்றலை உருவாக்கவில்லை. ஏற்கெனவே வளர்ந்துவந்த ஆராய்ச்சியின் திறனை கணினிப் பார்வைத் துறை புறக்கணிக்க முடியாத வகையில் எடுத்துக்காட்டியது.
9. AlexNet ஏன் கணினிப் பார்வையை மாற்றியது?
முன்னைய பல கணினிப் பார்வை அமைப்புகள் மனிதர்கள் தனியாக வடிவமைத்த அம்சப் பிரித்தெடுப்பு முறைகளைப் பெரிதும் சார்ந்திருந்தன. CNN-களோ, பயிற்சியின் ஒரு பகுதியாகத் தரவுகளிலிருந்து பிரதிநிதித்துவங்களைக் கற்றுக்கொள்கின்றன.
இதனை “மனிதர்கள் உருவாக்கிய அல்காரிதம்களை இயந்திரங்கள் வென்றன” என்று கூறுவது துல்லியமல்ல. நரம்பியல் வலையமைப்புகளின் கட்டமைப்புகளையும் பயிற்சி முறைகளையும் மனிதர்களே வடிவமைக்கின்றனர். முக்கிய மாற்றம், அம்சங்களின் பெரும்பகுதியை எடுத்துக்காட்டுகளிலிருந்து கற்றுக்கொள்ளும் அணுகுமுறைக்குத் துறை நகர்ந்ததாகும்.
AlexNet வெற்றிக்கு முந்தைய CNN ஆய்வு, பயிற்சி நுட்பங்கள், பெரிய தரவுத்தொகுப்புகள், பொதுவான மதிப்பீடு, GPU வன்பொருள், திறமையான மென்பொருள் மற்றும் குறிப்பிடத்தக்க போட்டி முடிவு ஆகிய அனைத்தும் பங்களித்தன.
10. AlexNet-இலிருந்து நவீன கணினிப் பார்வை வரை
கீழே உள்ள காலப்பிரிவுகள் விளக்கத்திற்கானவை. அவை ஒன்றையொன்று முற்றிலும் மாற்றியவை அல்ல; CNN-களும் திறன்வாய்ந்த சிறிய மாதிரிகளும் Transformer-களும் இன்றும் இணைந்து பயன்படுகின்றன.
2013–2014: CNN-களைப் புரிந்துகொள்ளலும் ஆழப்படுத்தலும்
ZFNet: காட்சிப்படுத்தல் மற்றும் படத்தின் பகுதிகளை மறைத்துச் சோதிக்கும் முறைகள் மூலம் வலையமைப்பின் செயல்பாட்டை ஆராய்ந்தது. ஆரம்ப அடுக்குகளின் Filter மற்றும் Stride அளவுகளிலும் மாற்றங்கள் செய்யப்பட்டன. அதன் பங்களிப்பு சிறிய Filter-கள் மட்டுமல்ல; மாதிரி எதற்குப் பதிலளிக்கிறது என்பதை ஆய்வு செய்ததும் முக்கியமானது. ZFNet ஆய்வு
VGG: பெரும்பாலும் சிறிய 3×3 Convolution-களைப் பயன்படுத்தி 16 அல்லது 19 எடை கொண்ட அடுக்குகள் வரையிலான கட்டமைப்புகளை ஆராய்ந்தது. சோதிக்கப்பட்ட சூழல்களில் ஆழத்தின் முக்கியத்துவத்தை இது காட்டியது; எல்லாச் சூழல்களிலும் ஆழம் அதிகரித்தால் சிறந்த முடிவு கிடைக்கும் என்பது இதன் பொருளல்ல. VGG ஆய்வு
GoogLeNet / Inception: பல அளவுகளில் இணையாகச் செயல்படும் பாதைகளை Inception தொகுதிகளில் இணைத்தது. கணக்கீட்டைக் கட்டுப்படுத்த 1×1 Convolution போன்ற முறைகளையும் பயன்படுத்தியது. GoogLeNet ஆய்வு
2015–2017: Residual மற்றும் Dense இணைப்புகள்
ResNet எச்சக் கற்றல் (Residual learning) முறையை அறிமுகப்படுத்தியது. வடிவங்கள் பொருந்தும் ஒரு எளிய தொகுதியில்:
y = x + F(x)
இங்குள்ள Shortcut, தகவலும் Gradient-உம் கற்றுக்கொள்ளப்பட்ட மாற்றத்தைச் சுற்றி நேரடியாகப் பயணிக்க உதவுகிறது. இது ஆழமான வலையமைப்புகளின் Optimisation-க்கு உதவினாலும், Gradient பிரச்சினை ஒருபோதும் ஏற்படாது அல்லது ஆழம் அதிகரிக்கும்போதெல்லாம் முடிவு சிறக்கும் என்று உறுதியளிக்காது. அசல் ஆய்வு, தனது Degradation problem-ஐ Vanishing gradients பிரச்சினையிலிருந்து வேறுபடுத்துகிறது. ResNet ஆய்வு
DenseNet-இல் ஒரு Dense block-இன் ஒவ்வொரு அடுக்கும், முந்தைய அடுக்குகளின் அம்ச வரைபடங்களை இணைத்து (Concatenation) உள்ளீடாகப் பெறுகிறது. இதனால் அம்சங்களை மீண்டும் பயன்படுத்த முடிகிறது. இந்த Concatenation, ResNet-இன் எளிய கூட்டல் இணைப்பிலிருந்து வேறுபட்டது. குறைவான அளவுருக்கள் இருப்பது எப்போதும் குறைவான இயக்க நேரம் அல்லது நினைவகப் பயன்பாட்டைக் குறிக்காது. DenseNet ஆய்வு
2017–2019: சிறிய சாதனங்களுக்கான செயல்திறன்
MobileNet என்பது Depthwise separable convolutions மற்றும் பல கட்டமைப்பு விருப்பங்களைப் பயன்படுத்தி துல்லியத்திற்கும் கணக்கீட்டுச் செலவிற்கும் இடையே சமநிலை ஏற்படுத்துகிறது. கணக்கீடுகள் குறைவது, ஒவ்வொரு சாதனத்திலும் அதே விகிதத்தில் இயக்க நேரம் குறையும் என்பதற்கு உத்தரவாதமல்ல. MobileNet ஆய்வு
EfficientNet, வலையமைப்பின் ஆழம், அகலம் மற்றும் உள்ளீட்டுப் படத் தெளிவுத்திறன் ஆகியவற்றைச் சமநிலையாக மாற்றும் Compound scaling முறையை அறிமுகப்படுத்தியது. சிறந்த நடைமுறைக் கட்டமைப்பு வன்பொருளையும் பணியையும் சார்ந்தது. EfficientNet ஆய்வு
2020 முதல்: Transformer, பிரதிநிதித்துவக் கற்றல் மற்றும் பன்முக மாதிரிகள்
2017-இல் தொடர்தரவு செயலாக்கத்திற்காக அறிமுகப்படுத்தப்பட்ட Transformer கட்டமைப்பைத் தொடர்ந்து, Vision Transformer (ViT) ஒரு படத்தைச் சிறிய பகுதிகளாகப் பிரித்து, கற்றுக்கொள்ளப்பட்ட Patch embeddings வரிசையாக மாற்றி Transformer மூலம் செயலாக்கியது. 16×16 என்பது பொதுவான ஓர் உதாரணம்; Patch அளவு எல்லா ViT மாதிரிகளிலும் ஒன்றல்ல. பெரிய அளவிலான Pretraining அதன் ஆய்வு முடிவுகளில் முக்கியப் பங்காற்றியது. Transformer ஆய்வு; ViT ஆய்வு
Swin Transformer படிநிலை அமைப்பையும் இடம் நகரும் உள்ளூர் சாளரங்களையும் (Shifted windows) பயன்படுத்தி Object detection மற்றும் Segmentation போன்ற பணிகளுக்கு உதவியது. Swin ஆய்வு
ConvNeXt, நவீனப்படுத்தப்பட்ட CNN வடிவமைப்புகளும் சமகால Transformer-களுடன் போட்டியிட முடியும் என்பதைக் காட்டியது. எனவே Transformer வந்ததால் CNN தேவையற்றதாகிவிட்டது என்று கூற முடியாது. ConvNeXt ஆய்வு
CLIP, படங்களுக்கும் உரைகளுக்கும் இடையே தொடர்புடைய பிரதிநிதித்துவங்களைக் கற்றுக்கொண்டு, Zero-shot வகைப்பாட்டுக்கு உதவியது. ஆனால் அது தனியாக ஒரு பொதுவான உரையாடல் Multimodal assistant அல்ல. CLIP ஆய்வு
DINOv2, நேரடி வகைப்பாட்டுப் பெயர்களை மட்டும் சாராமல், பயனுள்ள காட்சிப் பிரதிநிதித்துவங்களைக் கற்றுக்கொள்ளும் Self-supervised learning அணுகுமுறையை எடுத்துக்காட்டுகிறது. DINOv2 ஆய்வு
Segment Anything (SAM) என்பது குறிப்புகளைப் பயன்படுத்திப் படங்களின் பகுதிகளைப் பிரிக்கும் Segmentation மாதிரி. SAM 2 இதனைப் படங்களுக்கும் காணொளிக்கும் விரிவுபடுத்துகிறது. இவற்றை பொதுவான Multimodal மொழி மாதிரிகளுடன் ஒன்றாகக் கருதக்கூடாது. SAM ஆய்வு; SAM 2 ஆய்வு
LLaVA போன்ற மாதிரிகள் காட்சிப் பிரதிநிதித்துவங்களை மொழி மாதிரிகளுடனும் அறிவுறுத்தல்களைப் பின்பற்றும் திறனுடனும் இணைக்கின்றன. இது வேறுபட்ட ஒரு பன்முக அணுகுமுறையாகும். LLaVA ஆய்வு
11. AlexNet-க்குப் பின் CUDA மற்றும் பிற வன்பொருட்கள்
2012-க்குப் பின்னர் GPU மென்பொருளும் வன்பொருளும் தொடர்ந்து வளர்ச்சியடைந்தன. cuDNN போன்ற நூலகங்கள், Deep Learning Framework-களுக்கான மேம்படுத்தப்பட்ட அடிப்படைக் கணக்கீடுகளை வழங்கின. பின்னர் NVIDIA கட்டமைப்புகளில் Tensor Cores போன்ற சிறப்பு Matrix கணக்கீட்டு வசதிகள் அறிமுகமானன. இவை பிற்கால முன்னேற்றங்கள்; AlexNet பயன்படுத்திய GTX 580-இல் அவை இருந்ததாகக் கூறக்கூடாது. cuDNN ஆய்வு; Tensor Cores பற்றி NVIDIA
அதேவேளை, AI என்பது CUDA-வுக்கு மட்டுப்பட்டதல்ல. CPU-களும் பிற வகைச் செயலிகளும் முக்கியமானவை. உதாரணமாக, அசல் ViT ஆராய்ச்சி TPU வன்பொருளைப் பயன்படுத்தியதாகக் குறிப்பிடுகிறது. ViT அசல் ஆய்வு
12. முடிவுரை
ஆழ்கற்றலின் உருவாக்கத்தை ஒரு தனிக் கண்டுபிடிப்பாக அல்லாமல், நீண்டகால வளர்ச்சிகளின் சங்கமமாகப் புரிந்துகொள்வதே சிறந்தது:
செயற்கை நரம்பணுக்கள் → கற்றல் வழிமுறைகள் → CNN மற்றும் தொடர்தரவு மாதிரிகள் → பெரிய தரவுத்தொகுப்புகள் → இணைக் கணக்கீடு → AlexNet → Residual networks, திறன்வாய்ந்த கட்டமைப்புகள், Transformer மற்றும் பன்முக அமைப்புகள்.
NVIDIA GPU-களில் ஆராய்ச்சியை விரைவுபடுத்த CUDA ஒரு முக்கிய உதவித் தளமாக இருந்தது. முன்னரே உருவான கருத்துகள், கணிசமான தரவு மற்றும் அணுகக்கூடிய கணக்கீட்டுத் திறன் ஆகியவை ஒன்றிணைந்தால் என்ன சாதிக்க முடியும் என்பதை AlexNet எடுத்துக்காட்டியது. இவற்றில் ஏதாவது ஒன்று மட்டும் முழு வரலாற்றையும் விளக்காது.
ஆய்வுக் குறிப்பு: இது அசல் ஆய்வுக் கட்டுரைகளையும் அதிகாரப்பூர்வ ஆவணங்களையும் அடிப்படையாகக் கொண்ட வரலாற்று ஆய்வுக் கட்டுரை. இதற்காகப் புதிய பரிசோதனைகள் நடத்தப்படவில்லை.