Batch Normalization மூலம் AlexNet-ஐ நவீனப்படுத்துதல்: தரவு பைப்லைன் மற்றும் முழுமையான பயிற்சி ஸ்கிரிப்ட்
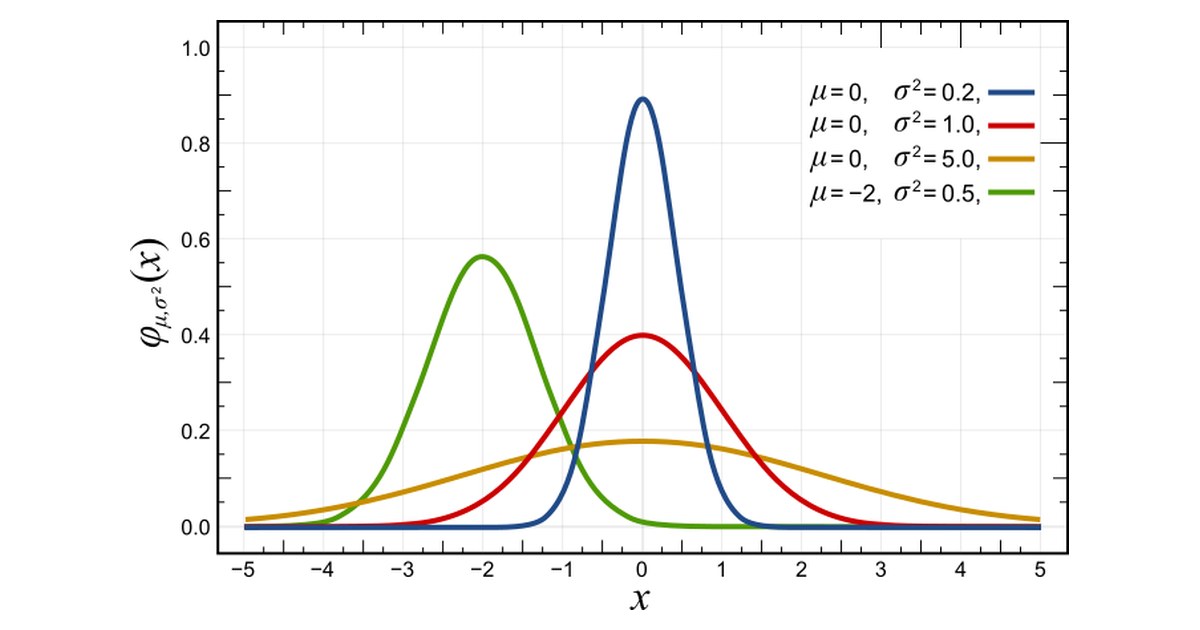
விளக்கப்படம்: Normal distribution curves with different means and variances; illustrative of the re-centring and rescaling that batch normalization applies. படம்: Inductiveload, public domain, via Wikimedia Commons.
AlexNet-ஐ Batch Normalization மூலம் நவீனப்படுத்தி, நிலையான தரவுத்தொகுப்புகளுக்கும் (CIFAR-10 போன்றவை) தனிப்பயன் பட கோப்புறைகளுக்கும் data augmentation-ஐ அமைக்கும், உற்பத்திக்குத் தயாரான முழுமையான PyTorch பைப்லைன் இதோ.
1. AlexNet-இல் Batch Normalization ஏன் சேர்க்க வேண்டும்?
AlexNet-இன் 2012 பதிப்பு Local Response Normalization (LRN)-ஐ நம்பியிருந்தது; வெடிக்கும் அல்லது மறையும் gradients-ஐத் தவிர்க்க கவனமான learning-rate திட்டமிடல் தேவைப்பட்டது. ஒவ்வொரு convolutional அடுக்கிற்குப் பிறகும் நேரடியாக BatchNorm2d-ஐச் சேர்ப்பது பெரிய மேம்பாடுகளைத் தருகிறது:
- வேகமான ஒருங்கிணைவு. அடுக்கு உள்ளீடுகளை இயல்பாக்குவது activation பரவல்களை நிலைப்படுத்துகிறது; இதனால் விலகிச் செல்லாமல் அதிக learning rate-களைப் பயன்படுத்தலாம்.
- குறைந்த overfitting. BatchNorm, mini-batch-கள் முழுவதும் சிறிய இரைச்சலை அறிமுகப்படுத்தி, Dropout-உடன் சேர்ந்து இயற்கையான regularizer ஆகச் செயல்படுகிறது.
- மிகைப்படியான bias நீக்கம். Conv2d-ஐத் தொடர்ந்து BatchNorm2d வரும்போது, convolutional அடுக்கில் bias=False என அமைப்பது அளவுருக்களைச் சேமிக்கிறது; ஏனெனில் BatchNorm-இன் கற்கக்கூடிய shift அளவுரு (β) convolution bias-ஐ மாற்றுகிறது.
2. Data Augmentation மற்றும் பைப்லைன் உத்தி
AlexNet சுமார் 224 × 224 பிக்சல் உள்ளீடுகளை எதிர்பார்க்கிறது. CIFAR-10 போன்ற தரவுத்தொகுப்புகள் மிகச் சிறியவை (32 × 32 பிக்சல்கள்) என்பதால், அவற்றை AlexNet-இன் 11×11 stride-4 முதல் அடுக்கில் நேரடியாகச் செலுத்தினால் இடஞ்சார்ந்த பரிமாணங்கள் உடனடியாகப் பூஜ்யமாகச் சுருங்கிவிடும்.
- பயிற்சி மாற்றங்கள் (Training transforms). படங்களை 256×256 வரை பெரிதாக்கி, சீரற்ற 224×224 crop எடுத்து, சீரற்ற கிடைமட்டப் புரட்டல்களைப் பயன்படுத்தி, brightness/contrast-ஐ மாற்றுங்கள்.
- சரிபார்ப்பு/சோதனை மாற்றங்கள் (Validation/Test transforms). மதிப்பீட்டு அளவீடுகள் சீராக இருக்க, சீரற்ற தன்மை இல்லாமல் 256×256 ஆக மாற்றி, உறுதியான மைய 224×224 crop எடுங்கள்.
- Channel இயல்பாக்கம். ImageNet-இன் சராசரி மற்றும் திட்ட விலக்கத்தைப் (mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]) பயன்படுத்தி RGB மதிப்புகளைத் தரப்படுத்துங்கள்.
3. முழுமையான நவீனப்படுத்தப்பட்ட PyTorch ஸ்கிரிப்ட்
இந்த ஒற்றை ஸ்கிரிப்ட்டில் Batch Normalization உடனான AlexNet, CIFAR-10 மற்றும் தனிப்பயன் கோப்புறைகளுக்கான தரவு ஏற்றிகள், முழுமையான பயிற்சி + சரிபார்ப்பு சுழற்சி ஆகியவை உள்ளன.
import os
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# ==========================================
# 1. Modernized AlexNet with BatchNorm
# ==========================================
class ModernAlexNet(nn.Module):
    def __init__(self, num_classes: int = 10, dropout: float = 0.5):
        super().__init__()

        self.features = nn.Sequential(
            # Block 1: Conv -> BatchNorm -> ReLU -> MaxPool
            nn.Conv2d(3, 64, kernel_size=11, stride=4, padding=2, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Block 2
            nn.Conv2d(64, 192, kernel_size=5, padding=2, bias=False),
            nn.BatchNorm2d(192),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Block 3
            nn.Conv2d(192, 384, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(384),
            nn.ReLU(inplace=True),

            # Block 4
            nn.Conv2d(384, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),

            # Block 5
            nn.Conv2d(256, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),
        )

        self.avgpool = nn.AdaptiveAvgPool2d((6, 6))

        self.classifier = nn.Sequential(
            nn.Dropout(p=dropout),
            nn.Linear(256 * 6 * 6, 4096, bias=False),
            nn.BatchNorm1d(4096),
            nn.ReLU(inplace=True),

            nn.Dropout(p=dropout),
            nn.Linear(4096, 4096, bias=False),
            nn.BatchNorm1d(4096),
            nn.ReLU(inplace=True),

            nn.Linear(4096, num_classes),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x


# ==========================================
# 2. Data Pipeline & Augmentations
# ==========================================
def get_dataloaders(dataset_type: str = "cifar10", data_dir: str = "./data", batch_size: int = 64):
    # Standard ImageNet normalization stats
    norm_mean = [0.485, 0.456, 0.406]
    norm_std = [0.229, 0.224, 0.225]

    train_transforms = transforms.Compose([
        transforms.Resize((256, 256)),
        transforms.RandomCrop((224, 224)),
        transforms.RandomHorizontalFlip(p=0.5),
        transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
        transforms.ToTensor(),
        transforms.Normalize(mean=norm_mean, std=norm_std),
    ])

    val_transforms = transforms.Compose([
        transforms.Resize((256, 256)),
        transforms.CenterCrop((224, 224)),
        transforms.ToTensor(),
        transforms.Normalize(mean=norm_mean, std=norm_std),
    ])

    if dataset_type == "cifar10":
        train_dataset = datasets.CIFAR10(root=data_dir, train=True, download=True, transform=train_transforms)
        val_dataset = datasets.CIFAR10(root=data_dir, train=False, download=True, transform=val_transforms)
        num_classes = 10

    elif dataset_type == "folder":
        # Expects structure: data_dir/train/class_x/img.jpg & data_dir/val/class_x/img.jpg
        train_dataset = datasets.ImageFolder(root=os.path.join(data_dir, "train"), transform=train_transforms)
        val_dataset = datasets.ImageFolder(root=os.path.join(data_dir, "val"), transform=val_transforms)
        num_classes = len(train_dataset.classes)
    else:
        raise ValueError("dataset_type must be 'cifar10' or 'folder'")

    train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=4, pin_memory=True)
    val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=4, pin_memory=True)

    return train_loader, val_loader, num_classes


# ==========================================
# 3. Training & Evaluation Engine
# ==========================================
def train_one_epoch(model, loader, criterion, optimizer, device):
    model.train()
    running_loss, correct, total = 0.0, 0, 0

    for images, labels in loader:
        images, labels = images.to(device, non_blocking=True), labels.to(device, non_blocking=True)

        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * images.size(0)
        _, predicted = outputs.max(1)
        total += labels.size(0)
        correct += predicted.eq(labels).sum().item()

    return running_loss / total, 100.0 * correct / total


@torch.no_grad()
def evaluate(model, loader, criterion, device):
    model.eval()
    running_loss, correct, total = 0.0, 0, 0

    for images, labels in loader:
        images, labels = images.to(device, non_blocking=True), labels.to(device, non_blocking=True)
        outputs = model(images)
        loss = criterion(outputs, labels)

        running_loss += loss.item() * images.size(0)
        _, predicted = outputs.max(1)
        total += labels.size(0)
        correct += predicted.eq(labels).sum().item()

    return running_loss / total, 100.0 * correct / total


if __name__ == "__main__":
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    # Switch dataset_type="folder" and point data_dir to your custom dataset path
    train_loader, val_loader, num_classes = get_dataloaders(
        dataset_type="cifar10",
        data_dir="./data",
        batch_size=64
    )

    model = ModernAlexNet(num_classes=num_classes).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)
    scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=10)

    epochs = 10
    for epoch in range(1, epochs + 1):
        train_loss, train_acc = train_one_epoch(model, train_loader, criterion, optimizer, device)
        val_loss, val_acc = evaluate(model, val_loader, criterion, device)
        scheduler.step()

        print(f"Epoch [{epoch:02d}/{epochs}] "
              f"Train Loss: {train_loss:.4f} | Train Acc: {train_acc:.2f}% | "
              f"Val Loss: {val_loss:.4f} | Val Acc: {val_acc:.2f}%")
4. தனிப்பயன் தரவுத்தொகுப்புகளை இயக்குவதற்கான நடைமுறைக் குறிப்புகள்
- கோப்புறை அமைப்பு. dataset_type="folder" எனத் தேர்ந்தால், ஒவ்வொரு வகுப்பிற்கும் ஒரு துணைக் கோப்புறை இருக்கும்படி கோப்புகளை அமையுங்கள்:
my_dataset/
├── train/
│   ├── cats/
│   └── dogs/
└── val/
    ├── cats/
└── dogs/- BatchNorm1d உடனான batch size விதி. classifier-இல் nn.BatchNorm1d(4096) இருப்பதால், ஒரு epoch-இன் கடைசி மீதமுள்ள batch-இல் உங்கள் பயிற்சி batch size 1 ஆகக் குறையாதபடி உறுதிசெய்யுங்கள். உங்கள் தரவுத்தொகுப்பு அளவு 1 படத்தை மீதமாக விட்டால், train_loader-க்குள் drop_last=True எனக் கொடுங்கள்.
- சிறிய தரவுத்தொகுப்புகள் (< 5,000 படங்கள்). சிறிய தனிப்பயன் தரவுத்தொகுப்பில் 57+ மில்லியன் அளவுருக்களைப் புதிதாகப் பயிற்றுவிப்பது, BatchNorm மற்றும் Dropout இருந்தாலும் overfitting ஆகலாம். சரிபார்ப்புத் துல்லியம் முன்கூட்டியே தேங்கினால், முன்-பயிற்சி பெற்ற மாதிரியில் self.features-ஐ முடக்குவது அல்லது அடர்த்தியான அடுக்குகளை 4096-இலிருந்து 1024 ஆகச் சுருக்குவது குறித்துப் பரிசீலியுங்கள்.